"Lage der Gesetze": Gesetzesänderungen als Pull Requests sichtbar machen

Interessantes Projekt, das unter den gegebenen Voraussetzungen für mehr Klarheit sorgen kann.

Allerdings frage ich nich, warum das Problem nicht an der Wurzel gepackt wird. Wenn kryptische Dokumente Mensch und Maschine vor Schwierigkeiten stellen, wäre es dann nicht sinnvoll, von den kryptischen Dokumenten wegzukommen, statt immer ausgefeiltere Analyse-Werkzeuge zu bauen? Warum werden Gesetzesänderungen überhaupt als unleserliche Änderungstexte veröffentlicht? Könnte der Ablauf nicht so angepasst werden, dass leserliche Texte im Original und in der Neufassung veröffentlicht werden? Die Unterschiede können automatisch hervorgehoben und bei Bedarf als Änderungstext ausgeworfen werden, und zwar ohne Unschärfen, Halluzinationen, händische Nachprüfungen und auch ohne den mit KI verbundenen enormen Stromverbrauch.

Mir ist klar, dass das Projekt ein Versuch ist, mit der aktuellen Praxis besser umzugehen, was ich unterstützenswert finde. Ich finde es aber auch wichtig, das Übel an der Wurzel zu packen. Chaos mit KI zu bekämpfen, ist schön und gut. Noch schöner wäre aber, dem Chaos gar nicht erst freien Lauf zu lassen. Auch wenn das wahrscheinlich bedeutet, mit Menschen über Veränderungen sprechen zu müssen, die vielleicht wenig Lust auf Veränderung haben.

3 „Gefällt mir“

Klingt sehr interessant und machbar, ich habe hier ein Test mit dem Wehrdienstveränderungsgesetz gemacht. Das gröszte Problem bei der Analyse sind die ganzen Referenzen und Referenzen in den Referenzen. Das Beispiel hier ist sehr orientiert und nicht auf git basierend, aber es zeigt was momentan mit einem Claude agent und Opus 4.7 möglich ist:

1 „Gefällt mir“

Servus zusammen, ich würde mich auch sehr gerne an einem solchen Projekt beteiligen. Tatsächlich arbeite ich gerade an einer ähnlichen Sache für mein Studium :slight_smile:

Konsens-Mechanismus von KI-Agenten halte ich für zwingend notwendig, da die teils inkonsistente Formatierung & Formulierung der Drucksachen aus dem Bundestag (bzgl. Gesetzentwürfen und Änderungsanträgen usw.) eine Regelbasierte Erkennung sehr unschön macht.
In der Tat ist die bisherige Arbeit mit den verkündeten Gesetzen aus dem Bundesgesetzblatt (als Starting Point) aufgrund der Veröffentlichung in PDF-Form schon anstrengend genug. Wir sind unserer Zeit leider etwas voraus, ich sehne mich schon nach der Einführung von Standards wie LegalDocML :wink:

Als ersten Schritt finde ich aber die Erkennung von potenziell untergegangenen/unterschätzten Änderungen gar nicht so kompliziert: Eine gute Kandidatenfilterung wäre es, nach §-Nennungen in dem Text der Gesetzesänderung zu suchen, in welcher der genannte Paragraph aber nicht selbst vorkommt. Hier müsste die erste Alarmglocke läuten (wie die berüchtigte Gültigkeitserweiterung des § 3 bei der Veränderung im Wehrpflichtgesetz).

5 „Gefällt mir“

Hallo zusammen,

ich hatte wie angekündigt ein paar Experimente gemacht und man kann hier ein (statisches) Ergebnis als Beispiel sehen:

:backhand_index_pointing_right: https://synopsis-lac.vercel.app/

(die Split-Ansicht ist durch das Deployment ein kleines bisschen verbuggt, einfach links das andere Gesetz auswählen)

Grob zusammengefasst funktioniert das so (alles noch manuell):

Datenquellen:

  1. Bestandsgesetze kommen als XML von gesetze-im-internet
  2. Ein Gesetzesentwurf kommt als PDF von dserver.bundestag.de (Beispiel)

Prozess:

  1. Ein LLM (ich hatte Claude 4.7 verwendet) bekommt den Gesetzesentwurf soll daraus ein strukturiertes Schema aus “Replacements” erzeugen. Das Schema enthält dabei Dinge die ein Gesetzesentwurf ganz allgemein enthalten kann (z.B. “In § 13b: Ersetze “steuerbefreit” durch “steuerbegünstigt”).
    Das LLM bekommt dabei nicht den bisherigen Gesetzestext (weil das kompliziert ist und viel Kontext braucht), sondern erstellt nur die Regeln, was ersetzt werden muss.
  2. Wir wandeln die relevanten Bestandsgesetze (es können mehrere in einem Gesetzesentwurf referenziert werden) in Markdown um und wenden die Replacements darauf an.
  3. Ergebnis: Jeweils ein before.md & after.md für alle geänderten Gesetze

Die oben verlinkte (SvelteKit) Web App kann dann einen solchen “Gesetzes-Diff” darstellen. Aktuell wird sie nur mit statischen (aber echten) Daten zu einem Gesetzesentwurf zur Änderung des Stromsteuergesetzes gefüttert (einfach als random Beispiel :smiley: ).

Der Code liegt hier: Daniel Veihelmann / synopsis · GitLab

4 „Gefällt mir“

Also es würde mich eigentlich schon sehr wundern, wenn sie das nicht schon einrichten würden. Aber man wundert sich ja immer wieder…

Eigentlich sollte man ja meinen dass sie sehr professionell arbeiten und dazu gehören auch IT Hilfstools - und das wäre das erste was mir einfallen würde.

Kleiner Hinweis zum prompting: besser den Kontext kleinhalten, Anweisungen in Unterdateien auslagern, und diese je nach Aufgabe heranziehen lassen.
4.7 soll wirklich sehr viel besser sein bei juristischen Texten aber auch Finanzen als 4.6, während es bei coding nicht so große Unterschiede gibt.

Hatte letztens im ZDF auch eine reportage gesehen bei der sie gutachten erstellen lassen haben zu 1. AI, 2. studierende mit AI und 3. Nur studierende. AI hat sie geschlagen und es war nur ein prompt mit ungetunter gemini. Wäre grundsätzlich mal ein Thema was mich mehr interessieren würde, was dort gerade passiert. Die Softwareentwicklung wird jedenfalls gerade komplett auf den Kopf gestellt.

1 „Gefällt mir“

Das kann ich auf keinen Fall empfehlen. Die User (Abgeordnete und ihre Mitarbeiter, Medien, …) werden die Ergebnisse verwenden, als wären sie korrekt. So gut wie niemand wird sagen: „Aha, da scheint etwas kritisch zu sein. Jetzt gucke ich lieber nochmal ins Änderungsgesetz für den Fall, dass die KI halluziniert hat.“. So funktioniert der Mensch leider nicht.

Man könnte mit einem Ansatz rangehen den Perplexity aktuell mit dem „Modellrat“ für eine Max-User anbietet: Dabei beantworten mehrere verschiedene KI‑Modelle gleichzeitig dieselbe Frage. Ihre Antworten werden anschließend zu einem gemeinsamen Ergebnis zusammengeführt und Differenzen explizit aufgezeigt. Ich selbst habe noch keine Erfahrung damit.

Bin kein Techi, habe aber den Eindruck: Unabhängig von dem Modelrat sorgt im Standard-Such-Modus die spezielle Pexplexity.ai-Architektur (RAG: Retrieval-Augmented Generation-Architektur) dafür, dass weniger Halluzinationen auftreten . Diese KI basiert nicht auf einem eigenen Sprachmodell, sondern greift auf eine ganze Reihe der führenden LLMs zurück (GPT, Gemini, Claude, Sonet, Opus - jeweils die neusten Modelle - und einige mehr). RAG arbeitet in zwei Schritten: (1) Mit ihrer eigenen Suchmaschine sucht Perplexity zunächst Online-Quellen, die Teile der Antworten wahrscheinlich enthalten (ähnlich wie die Google Suchmaschine). (2) Mit ihrem eigenen Sprachmodell (Sonar) formuliert Perplexity dann den User-Prompt zu einem effektiven und effizienten Prompt zur Beantwortung der gestellten Frage um und reichert die Frage mit implizitem Domänenwissen um weiteren notwendigen Kontext an. Dann wird der re-formulierte Prompt und die gefundenen Quellen an ein Sprachmodell übergeben; dabei wird automatisch das im Hinblick auf Genauigkeit und Geschwindigkeit geeignetste Sprachmodell verwendet (man kann aber auch das zu verwendende Modell vorgeben). Das Sprachmodelle verwendet dann nur die übergebenen Quellen, um die Antwort zu generieren. Diese Vorgehensweise reduziert die Gefahr von Halluzinieren beträchtlich. Jede Aussage wird mit Quellenangaben versehen, die auf die genutzten Dokumente verweisen (trotzdem passiert es immer wieder, dass die Quelle nicht zu dem Text passt, der mit der Quellenangabe versehen wurde - die Textstelle ist trotzdem meistens, aber nicht immer, richtig). Der noch viel tiefergehende Forschungs- oder Research-Modus funktioniert anders. Aber ich nehme an, in einem solchen Projekt scheitert die Verwendung von Perplexity oder den anderen führenden LLMs an den Kosten?

3 „Gefällt mir“

Ich find die Idee super! Kann gerne die eine oder andere Review machen, als Informatik Studi

1 „Gefällt mir“

Vielen Dank allen, insbesondere für den ersten Lauf @loswochos. Wie gesagt habe ich gerade viel zu tun und bin bald länger im Urlaub. Aber hier sind der Transparenz halber ein paar erste Eckpunkte, wie ich das Ganze angehen würde (sorry, etwas technisch):

  1. Ich werde ein GitHub Repository anlegen, worin alle Referenzdaten leben – also aktuelle Gesetze, die veröffentlichten Dokumente (in welcher Form auch immer) als Originalquellen, und eine ausführliche Dokumentation, wie das Projekt strukturiert ist und wie es funktioniert und wie man es anpassen und ggf. sogar forken und intern (innerhalb von Parteien z.B.) verwenden kann.
  2. Es wird eine AGENTS.md geben, die einem Agenten erklärt wie es in dem Projekt zu arbeiten hat (eine CLAUDE.md mit Inhalt @AGENTS.md für Claude-Kompatibilität). Außerdem wird es einen .agents/skills Ordner geben, wo es für jede spezialisierte Aufgabe einen Agent Skill geben wird (mit Symlink via .claude/skills für Claude). Mögliche Beispiel-Skills: auto-fetch (lädt täglich aus APIs/Repos/Webseiten die neusten Dokumente), gesetzes-diff (wendet die Änderungsbeschreibung auf ein Gesetz an), gegen-check (smarte Strategien, die dabei helfen Fehler auszumerzen), gesetzes-update (bringt die gespeicherten Gesetze auf den neusten Stand), etc.
  3. Ein Satz Tools und Skripte und klassischer Code, die verschiedene mechanische Dinge tun können und ausführlich mit Unit Tests bestätigt und auf Randfälle getestet wurden. Sie werden an geeigneter Stelle in passenden Skills erwähnt und von der KI benutzt, um Token zu sparen und Verlässlichkeit dort zu steigern, wo die unscharfe Intelligenz eines LLM nicht notwendig ist. Was hier rein kommt, ergibt sich dann aus den realen Daten und diese Skripte werden iterativ gebaut und Stück für Stück verbessert. Zum Beispiel könnte es hier Parser geben, die bestimmte APIs oder Webseiten mit fester Struktur scrapen. Ich werde vermutlich eine Mischung aus Shell-Skripten und Swift-Skripten (via internes CLI tool) verwenden.
  4. Eine Backend App, das alle strukturiert im Repo vorliegenden Daten für Client-Apps (wie Webseiten, Mobile Apps oder Desktop-Anwendungen) als eine ausführlich dokumentierte und semantisch versionierte REST Schnittstelle im JSON-Format zur Verfügung stellt. Ein passendes OpenAPI-Dokument soll das Entwickeln von API-Clients erleichtern.
  5. Diese Backend-App werde ich in Vapor schreiben, da ich mich damit auskenne, es Open Source ist, inzwischen auf allen gängigen Plattformen läuft und Dank der Programmiersprache Swift auch viele sichere Eigenschaften einer modernen Sprache aufweist, die langfristig Fehlerraten gering hält. Natürlich wird das Deployment dieser App ausführlich dokumentiert und dank fertiger Skripte in empfohlenen Umgebungen mit wenig Aufwand für technisch affine Menschen umsetzbar sein.
  6. Eine statische Webseite auf lagedergesetze.org, die alles Wichtige auf einer Webseite übersichtlich und mitsamt schön visualisiertem Diff für normale Menschen verständlich darstellt, mitsamt ausführlicher Dokumentation, wie genau es entstanden ist und wie verlässlich die Daten sind und welche Unsicherheiten es an welchen Stellen gibt. Die Seite wird vollständig aus dem im Repo liegenden Dateien generiert und bei jedem Update der Daten automatisch neu deployed, um stets aktuell zu sein. Auch ein Export/Download der Seite in anderen Formaten kann angeboten werden, etwa als PDF – dazu würde die PDF beim Erstellen der statischen Seite auch aus den Daten im Projekt automatisch neu generiert. Der Fokus läge vorerst auf der Darstellung aller aktuellen Gesetzesvorhaben – später könnte man auch ein Archiv bauen mit Such- und Filter-Funktionen.
  7. Eine iOS-App (das ist mein Expertengebiet), die praktisch die Visualisierung der Webseite für Mobilgeräte optimiert in einer nativen Applikation darstellt und wo man sich ggf. sogar für Push-Nachrichten anmelden kann bei bestimmten Themenbereichen oder einzelnen Gesetzesvorhaben, um Änderungen dort sofort auf dem Schirm zu haben. Die Benutzeroberfläche und der Quellcode kann dann von anderen verwendet werden, um auch für Android eine native App zur Verfügung zu stellen, die ähnlich funktioniert.

Daten, Backend, und statische Webseite werden vermutlich alle in einem Repo leben. Für die iOS-App mache ich ein getrenntes Repo.

Falls jemand an einzelnen Bestandteilen bereits arbeiten möchte (Parser, Skripte, Skills, etc.) würde ich das dann natürlich einbeziehen und darauf aufbauen.

1 „Gefällt mir“

Hallo zusammen,

ich freue mich sehr diese Thread zu finden. Ich musste beim Thema Synopse auch schon öfter an ein solches Tool (und GIT etc) denken und habe heute deswegen mal wieder in das Forum reingeschaut :smiley:

Ich hätte auch Lust in irgendeiner Form mitzuhelfen, falls noch Bedarf. Bin Data Scientist und kann gerne mitschreiben, testen oder Reviews machen. Ich nehme mir mal vor in den kommenden Tagen die Inputs oben durchzusehen und zu überlegen, ob ich schon was beitragen kann.

Zu dieser Idee fällt mir auch der Verein CorrelAid ein, der sich für Code- und Datenlösungen für die Zivilgesellschaft einsetzt. Die haben schon eine tolle Community und Infrastruktur für solche Projekte aufgebaut. Auf einer Veranstaltung habe ich auch mitbekommen, dass die verschiedene Erfahrung gemacht haben, wie technische Lösungen in die (zivilgesellschaftliche) Anwendung kommen (und nicht einschlafen). Dieser Aspekt liegt mir auch besonders am Herzen. Thema Usability, Kommunikation und Change Management sind wie oben schon angesprochen zentral damit eine technische Lösung auch tatsächlichen Nutzen bringt.

2 „Gefällt mir“

Tja, wie vielen andere hatte ich auch an so etwas gedacht, als ich die letzte Folge gehört hatte. Aber das dann in die Realität zu überführen ist schon noch mal was anderes. Deshalb schon mal Respekt und vielen Dank!

Ein paar Ideen:

  1. Nudging: Man könnte die Nutzer (vielleicht Parlamentarier !?) mit einem kleinen Banner dazu nudgen, doch ein Gesetzt einzubringen, was die Synopse verpflichtend macht für alle Gesetze. Da hat man dann bestimmt die richtige Zielgruppe. :slight_smile:
  2. Babysteps: Man kann zwar schnell etwas vibe coden, aber ob das dann auch wirklich zuverlässig und sicher betrieben werden kann ist dann im Detail vielleicht doch nicht so einfach. Deshalb könntest du ja erstmal das Tooling für die Umsetzung des Änderungsgesetztes erstellen und dann lokal ausführen und wenn gut, dann schon mal die daraus resultierenden Gesetze einchecken. Dann können sich das mal Experten anschauen, dazu reicht ja dann auch der Diff-Viewer von GitHub / Codeberg etc.
  3. Verifikation: Es wurde hier vielfach auf “Korrektheit” verwiesen. Ich glaube das das Konzept schon funktionieren wird, und vielleicht auch besser als 99% der Meschen das können. Allerdings kann es schon sein, dass es irgendwelche Edge-Cases gibt. Dazu könnten man sich doch existierende Gesetze bei denen es bereits v1 und v2 und ein Änderungsgesetz (diff) gibt und dann schauen ob Tool(v1, diff) = v2 ist. Bei Abweichung kann man dann den Skill tweaken.

Alles nur Serviervorschläge :wink:

1 „Gefällt mir“

Übrigens eine sehr nützliche Ressource für dieses Thema:

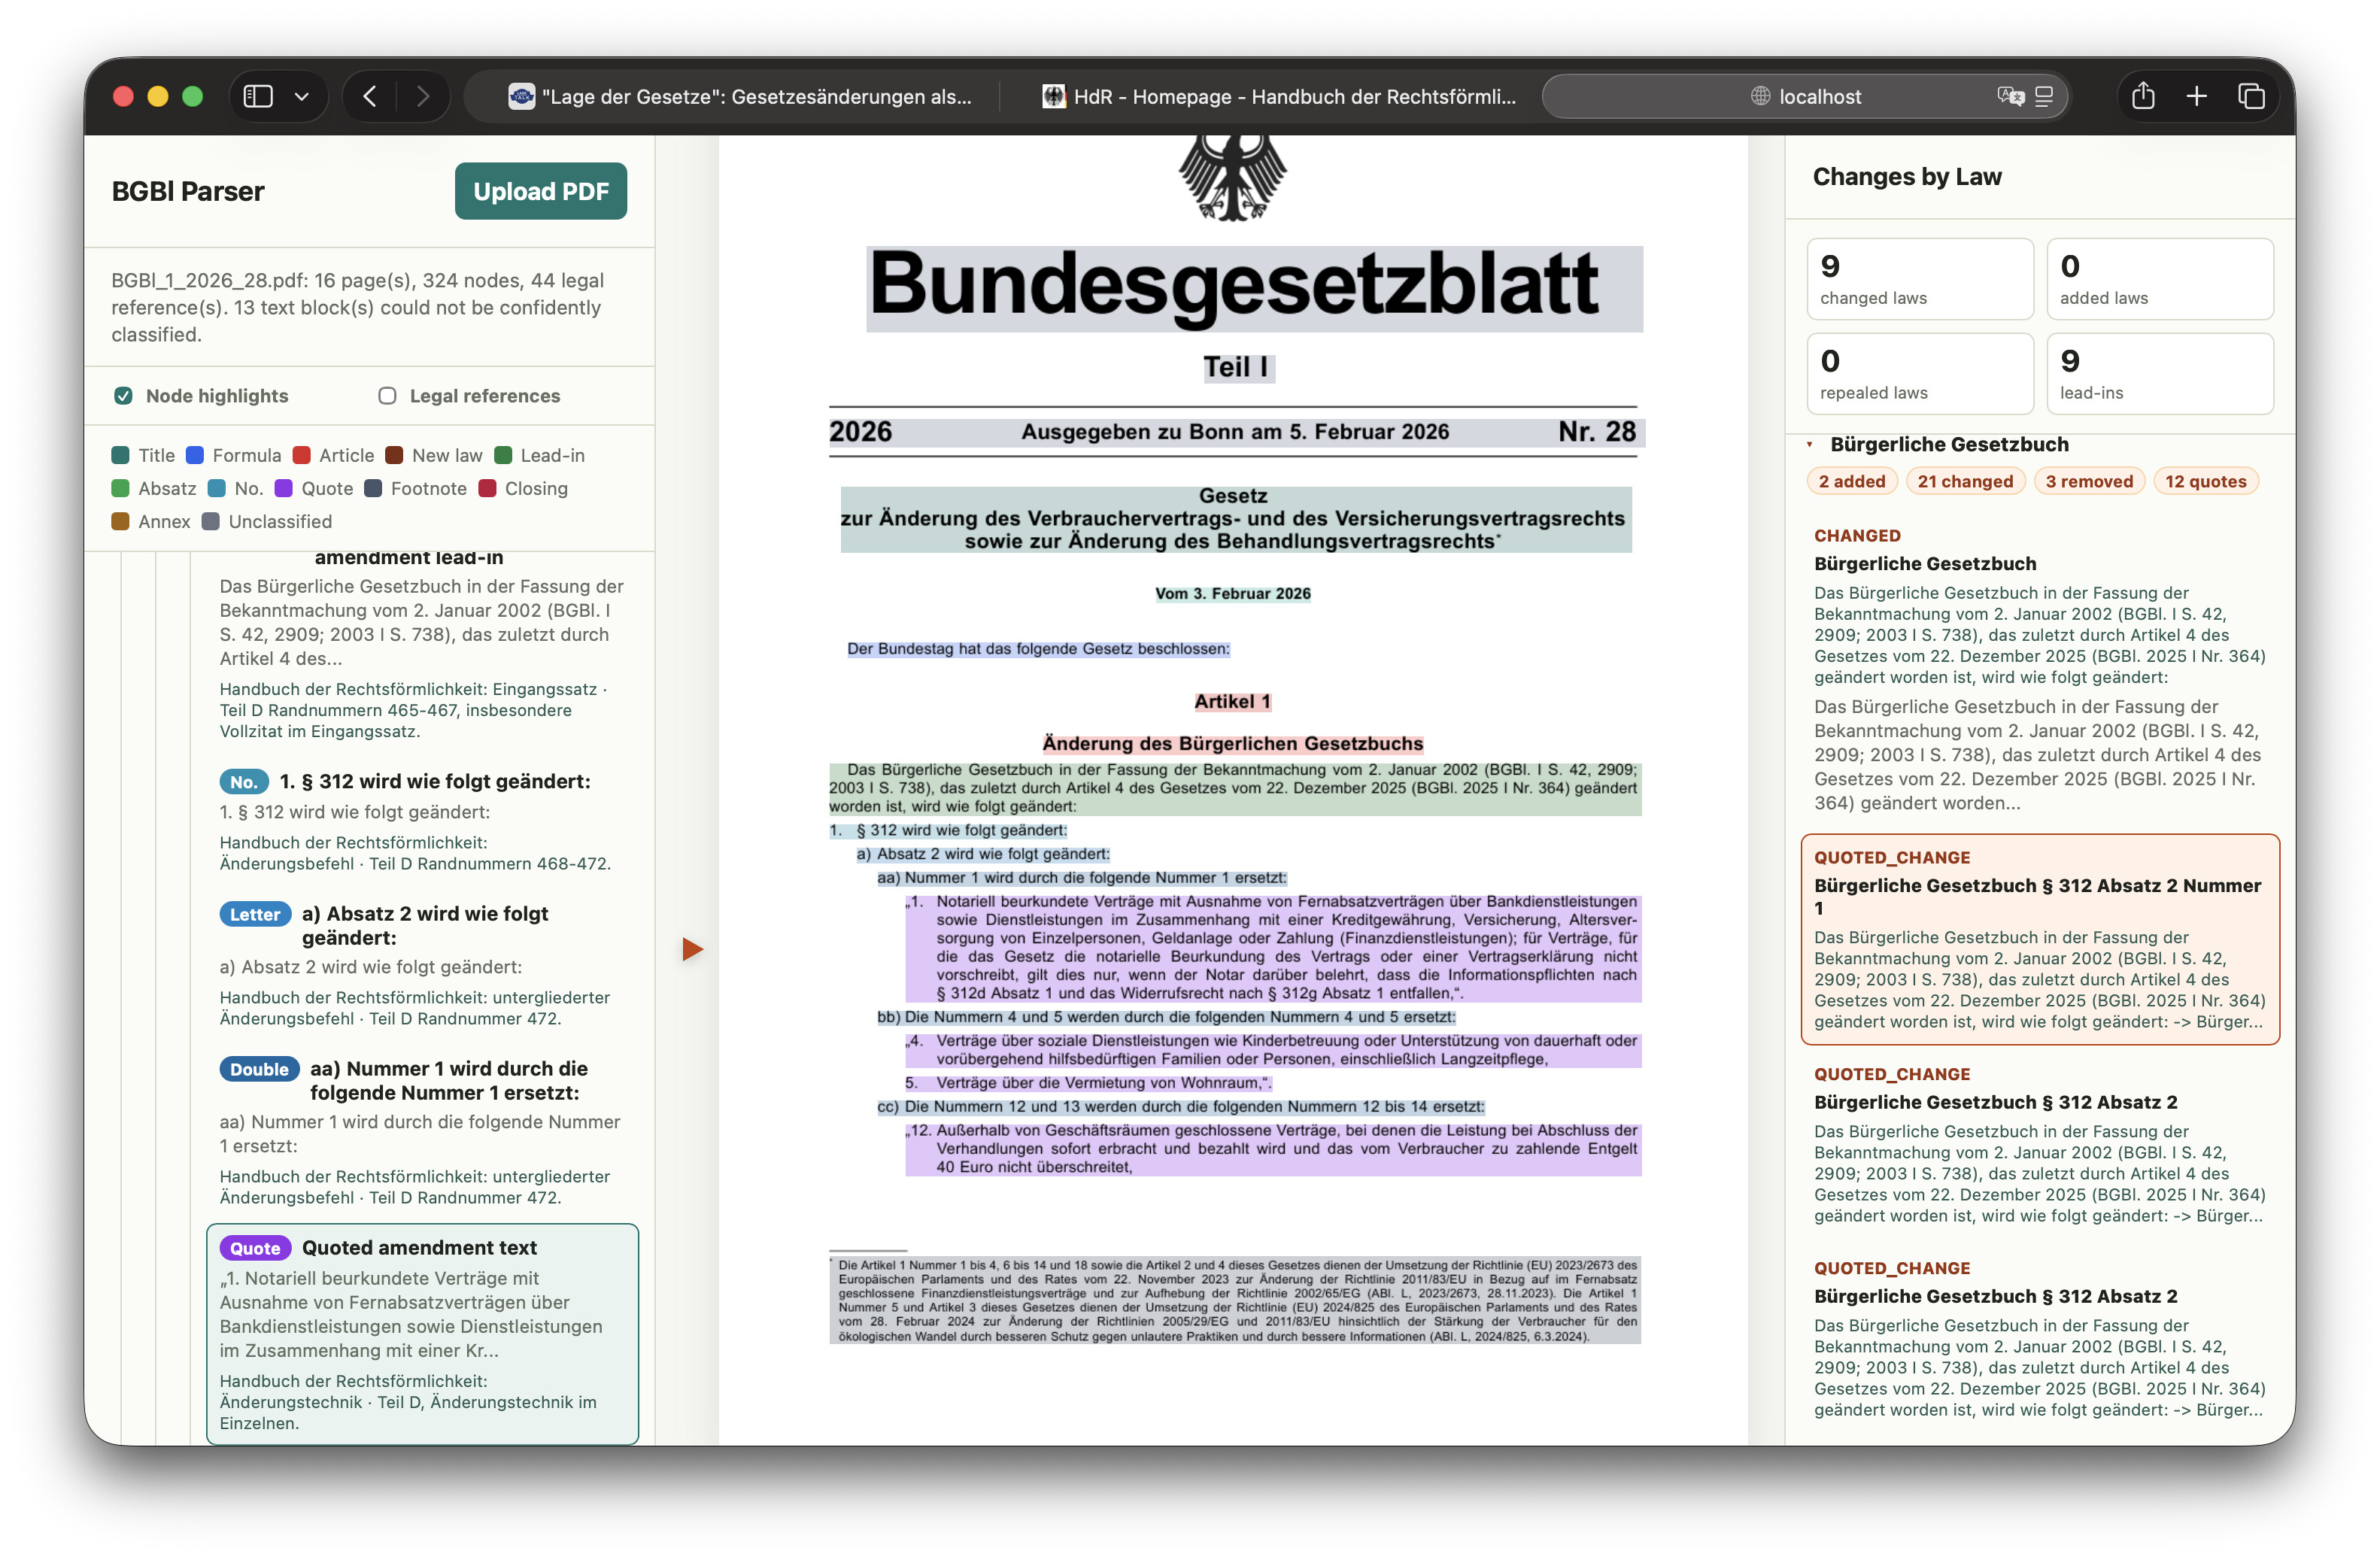
Die Standardformulierungen für Änderungsbefehle, Struktur von Änderungsgesetzen usw. sind im Prinzip konsolidiert und folgen im besten Fall dem vorgegebenen Muster des Handbuchs der Rechtsförmlichkeit, zu finden auf der Seite des BMJ.

Hiermit ließen sich viele der Textpassagen transparent nach dem Regelwerk des Handbuchs klassifizieren, unter Nutzung deterministischer Regeln zum Aufbau einer Hierarchie aus dem Gesetzestext. Den nicht trennscharfen Rest kann man im Anschluss gut mit KI klassifizieren.

Das ganze prototypisch für einen Text aus dem Bundesgesetzblatt:

3 „Gefällt mir“

Ich hab für mich mal angefangen die bisherigen Ideen und Ressourcen zusammenzuschreiben um einen Eindruck und Überblick zu bekommen. Richtig toller Input in alle Richtungen!

Das Ganze könnt ihr hier finden: Google Docs. Google Docs ist für einige vermutlich nicht die beste Lösung und darf gerne abgelöst werden. Macht gerne Kommentare. Bei Bedarf würde ich mich anbieten ein bissel Projektmanagement zu machen. Kann das dann auch gerne nach Github etc verschieben.

Zum Thema Selbstwirksamkeit kann ich sehr empfehlen, die Podcast-Folge der Parlamentsrevue anzuhören. Da gibt es einen tollen Aufruf mitzuhelfen um die mehr Transparenz zu schaffen (siehe Parlamentszusammenfasser).

Ich habe diese Webseite gefunden, die auch Synopsen anzeigen kann: Buzer.de. In wie weit das in den Gesetzgebungsprozess reinreicht kann ich (als Laie) nicht erkennen.

3 „Gefällt mir“

Ich werde das Thema vermutlich bei nächster Gelegenheit wieder aufgreifen und etwas weitertreiben, aber freue mich über Contributions / Kritik / etc (s. Repo-Link oben) :slight_smile:

Ein Mini-Fazit was ich (glaube ich) verstanden habe:

  1. buzer.de funktioniert nur für Gesetzesänderungen, die bereits in Kraft getreten sind
  2. Gesetzesentwürfe gibt es (was den Inhalt betrifft) nur als PDFs
  3. Die Entwürfe, die als Drucksache veröffentlicht werden, kann man über die API bekommen (inkl. Metadaten), aber wie gesagt nur als PDF: GitHub - bundesAPI/dip-bundestag-api: Bundestag: Dokumentations- und Informationssystem für Parlamentsmaterialien · GitHub
  4. Es gibt aber auch sog. Referentenentwürfe, die wir hier nicht bekommen
2 „Gefällt mir“

@loswochos Ich finde die Darstellung in der App sehr nice!

2. Gesetzesentwürfe gibt es (was den Inhalt betrifft) nur als PDFs

Wenn ich das richtig sehe, gibt es die auch in PDF, XML, JSON. Siehe hier.


Ich habe auch mal ein bisschen gevibed:
Eine WebApp, die ein hochgeladenes PDF (Gesetzesentwurf) über Claude in eine Synopse umwandelt. Beispiele zum Testen gibt’s hier wie @loswochos geschrieben hat unter "Drucksachen”.

Achtung: Ich bin kein Webentwickler :smiley: Repo hier: GitHub - JonLom/Synopsenersteller: Erstellt eine Synopse aus einem PDF mithilfe von KI und Online Quellen · GitHub

Was mir hier aufgefallen ist:

Es ist schwierig zu verifizieren, ob die Synopse sinnvoll ist, da man die Kombination (Gesetz vor Änderung + Gesetzesänderung/Entwurf + Gesetz nach Änderung) bräuchte. Da wäre es praktisch einen Datensatz aufzubauen um die Algorithmen/Agenten verlässlich bewerten zu können.

Versteht da jemand den Prozess und die öffentlichen Quellen gut genug um solche Daten zusammenzustellen? Hier sind wir wieder beim Thema Versionierung :see_no_evil_monkey: Eine Anzahl von 5-10 wäre schon sehr nützlich.

1 „Gefällt mir“

Die Entwürfe, die als Drucksache veröffentlicht werden, kann man über die API bekommen (inkl. Metadaten), aber wie gesagt nur als PDF

Das sollte nicht der Fall sein. Es gibt den Endpunkt /drucksache-text, der in der Antwort unter anderem ein `text`-Feld hat. Man braucht den Umweg über PDFs also nicht.

Ich denke bei den skills kannst du dich hier bedienen:

Ich hatte das ganze ein bisschen anders aufgesetzt, um das in verständliches Deutsch umzuschreiben und direkte und indirekte Effekte für die Bevölkerung rauszuschreiben, das müsste man also ein bisschen allgemeiner fassen. Das listing mit änderungen von Paragraphen etc ist allerdings bereits inbegriffen und funktioniert ganz gut.

2 „Gefällt mir“

Ich lasse diese Liste mal hier, ist eventuell interessant:

• BundesGit / deutsche Gesetze:

• Legalize – zentrale Organisation:

• Legalize – Spanien:

• Legalize – Hauptprojekt:

• SE-Lex – Schweden:

• SE-Lex Processor:
https://github.com/se-lex/sfs-parser
• USA – Congress Daten:

• USA – US Code als Git/Markdown:

• OpenGov Foundation Madison:

• Neuseeland – historisches Legislation-Repo:

• UK legislation.gov.uk GitHub Organisation:

• UK Legalize:

4 „Gefällt mir“

Danke für den TIpp mit dem /drucksache-text Endpoint! Leider liefert der aber wirklich nur plain Text zurück, das macht das Erkennen des Inhalts (was ist Überschrift, was Fließtext) im Zweifel sogar schwieriger fürchte ich

Guten Morgen, ein kurzes Update: Ich habe am Wochenende das ganze noch ein bisschen weitergetrieben. Grundsätzlich funktioniert folgender Flow:

Gesetzesentwürfe:

  1. Gesetzentwürfe via DIP-API abholen (PDFs plus ein paar Metadaten)
  2. In Markdown umwandeln und den Teil extrahieren, der beschreibt, welche Gesetze wie geändert werden sollen
  3. Input für das LLM, Ziel: Strukturierter Output (JSON) von Replacements , die auf Bestandsgesetze angewendet werden müssen
  4. Diese Replacements anwenden auf den

Bestandsgesetze:

  1. Die nötigen Bestandsgesetze via gesetze-im-internet.de laden (XML-Format)
  2. In Markdown umwandeln

Zusammenführung

  1. Markdown-Files jeweils als HTML rendern und dafür die Diff-Ansicht anzeigen
  2. Profit

Ich habe auch den Code in dem oben verlinkten Gitlab-Repo verbessert und eine Übersicht eingebaut, werde ich vermutlich heute Abend pushen.

Es gibt noch ein paar kleine Herausforderungen, beispielsweise Tabellen in Bestandsgesetzen, die wir noch korrekt handeln müssen. Außerdem sollte man die geänderten Paragraphen (also die Namen) richtig identifizieren und die Diff-Ansicht klüger machen. Insgesamt aber sieht das grundsätzlich ganz gut aus.

Jedenfalls 10x besser als nur die kryptischen Änderungen zu lesen würde ich meinen :smiley:

1 „Gefällt mir“

Wie versprochen melde ich mich noch im Juni und will euch mal auf den aktuellen Stand bringen:

Ich hab in den letzten Wochen aktiv daran gearbeitet, eine erste Version des Projekts zum Laufen zu bringen. Aus Zeitgründen musste ich bisher ziemlich viel vibe-coden, also die Spezifikation definieren und das Ergebnis prüfen, ohne selbst schon sauber durch den Quellcode zu gehen. Und ich bin mit dem Ergebnis auch noch nicht zufrieden. Auf den ersten Blick sind die wichtigsten Sachen da, aber der Teufel steckt bekanntlich im Detail. Da ist noch einiges zu tun, bevor ich das irgendjemandem ernsthaft vorlegen könnte.

Da das ja aber ein gemeinsames Projekt vieler Freiwilliger werden soll, teile ich den Stand trotzdem schon mal mit euch. Mit dem klaren Hinweis: Es gibt noch viele Baustellen, die Pipeline ist aktuell nicht scharf gestellt und enthält deshalb auch nicht die neuesten Gesetzesvorhaben. Auch das GitHub-Repo, also den Quellcode, muss ich erst selbst geradeziehen, bevor ich ihn teile.

Aber es steht schon einiges: eine Domain, eine gehostete Webseite, eine live API und sogar eine iOS-App, die auf dieser API aufsetzt. Während ich weiter daran arbeite, könnt ihr euch den aktuellen Stand auf der Webseite anschauen. Dort sind auch das Konzept und die API dokumentiert:

https://lagedergesetze.org/

Auch die iOS-App kann über Apples offizielle „TestFlight"-App als Beta installiert werden:

Ich werde ab jetzt Komponente für Komponente daran arbeiten und dieses Mal auch wirklich auf den Quellcode achten. Mein Ziel ist, Stück für Stück die Bestandteile glattzuziehen, die jetzt noch unfertig auf der Webseite zu sehen sind. Und immer wenn ein Teil fertig ist, melde ich mich, damit ihr euch besonders diesen Teil anschauen und Feedback dazu geben könnt.

Natürlich könnt ihr den aktuellen Stand schon mal kommentieren, nur bitte nicht zu viel Zeit investieren, weil wie gesagt eh vieles noch überarbeitet wird. Aber grob drüberschauen und mir allgemeines Feedback geben, wäre sicher jetzt schon sinnvoll. Ihr seht bestimmt Sachen, die ich nicht sehe. Und die grobe Richtung, in die es gehen soll, kann man auch schon gut erkennen.

Bin gespannt auf euer Feedback!

3 „Gefällt mir“